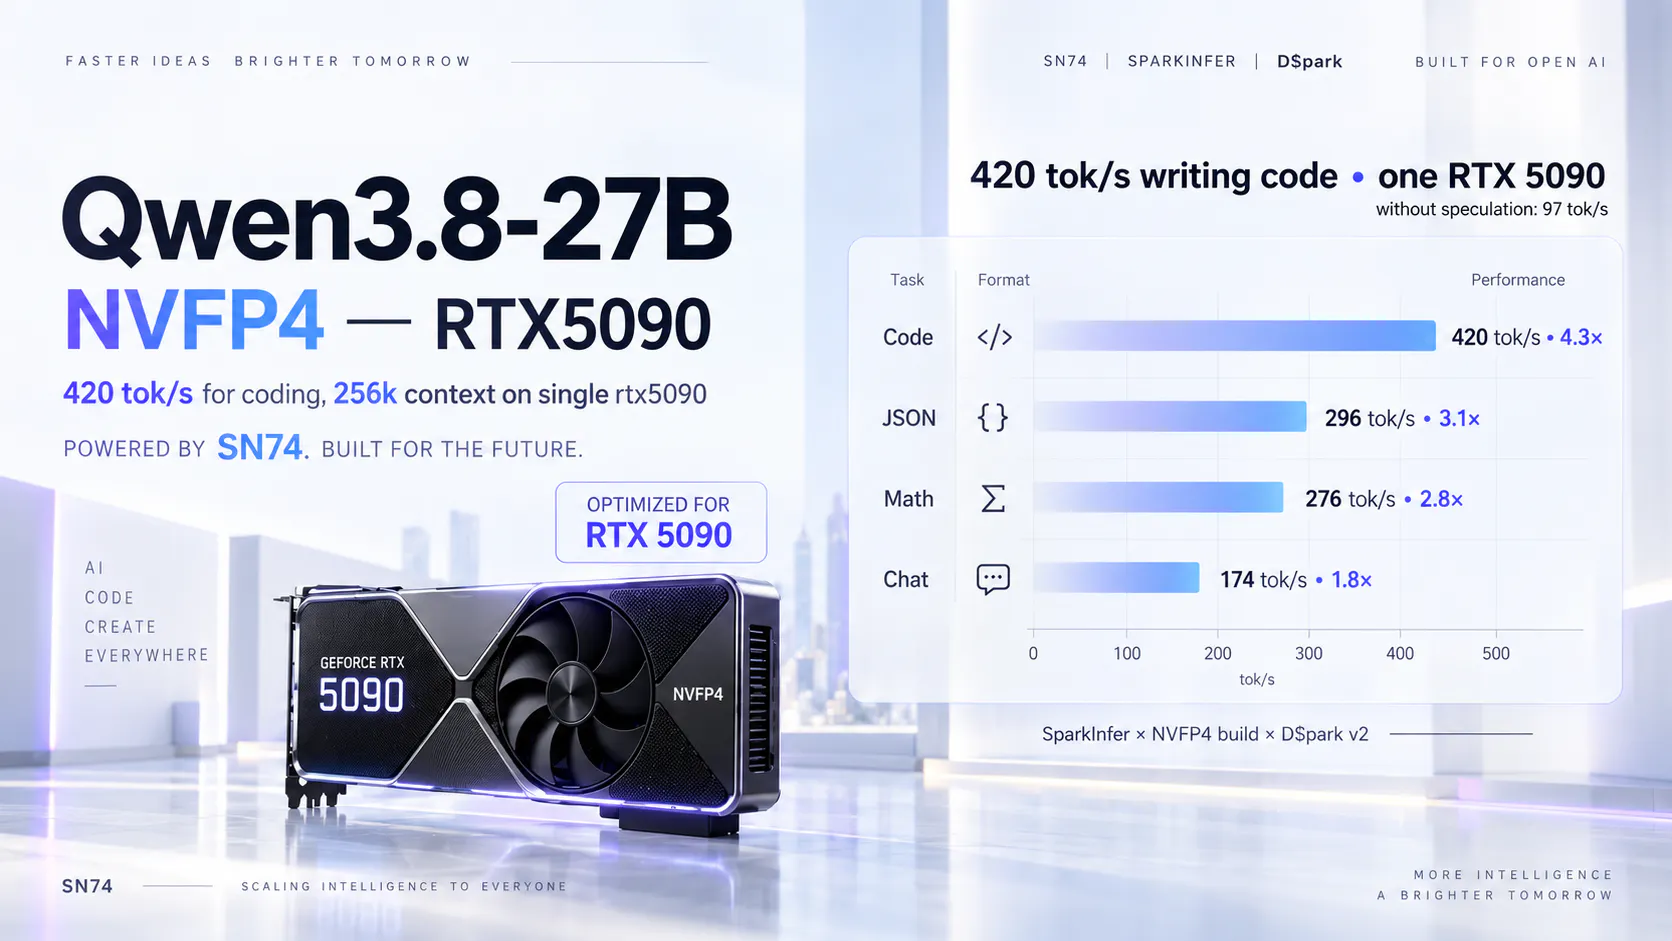
Fastest Qwen 3.8 27 on single RTX5090
ストックにはログインが必要です
単一のRTX 5090で実現する、超高速Qwen 3.8 27B推論
Artificial Intelligence
GitHub
Open Source
Blockchain
概要
- 高価なマルチGPU構成を必要とせず、1枚のRTX 5090でQwen 3.8 27Bを高速に推論できる最適化モデルです。
- NVFP4量子化とSparkInferの統合により、推論性能と計算効率を高め、最先端LLMの利用をより現実的にします。
主な特徴
- NVFP4向けに最適化されたモデルにより、GPUメモリや計算資源を抑えながら高性能な推論を実現します。
- SparkInferとの組み合わせで、単一GPU環境でも大規模言語モデルを高速にデプロイできる構成を提供します。
こんな人におすすめ
- 大規模な計算クラスターを用意せず、個人開発や小規模環境で高性能なLLMを動かしたい開発者に適しています。
- 推論コストを抑えつつ、モデル最適化や量子化技術を検証したい研究者・オープンソース開発者にも向いています。
投票数: 1