Prime Inference
ストックにはログインが必要です
最先端のオープンモデルを高速・高信頼で提供
Artificial Intelligence
概要
- 最先端のオープンソースモデルを本番環境で利用するための推論サービング基盤で、サーバーレスと予約容量を用途に応じて選択できます。
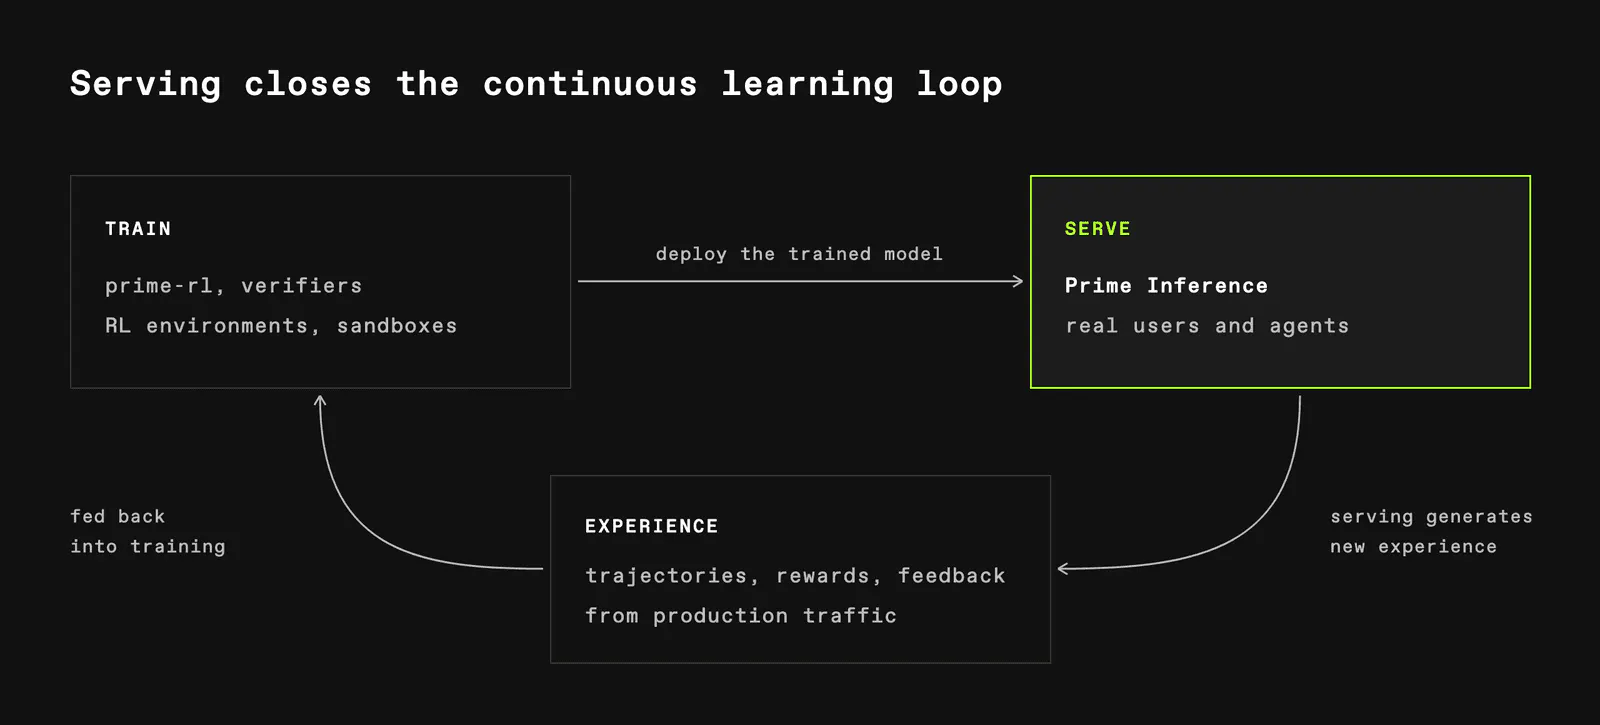
- Prime Intellect自身の大規模な強化学習、評価、長時間稼働するコーディングエージェントで実運用され、社内では1日約1兆トークンを処理しています。
主な特徴
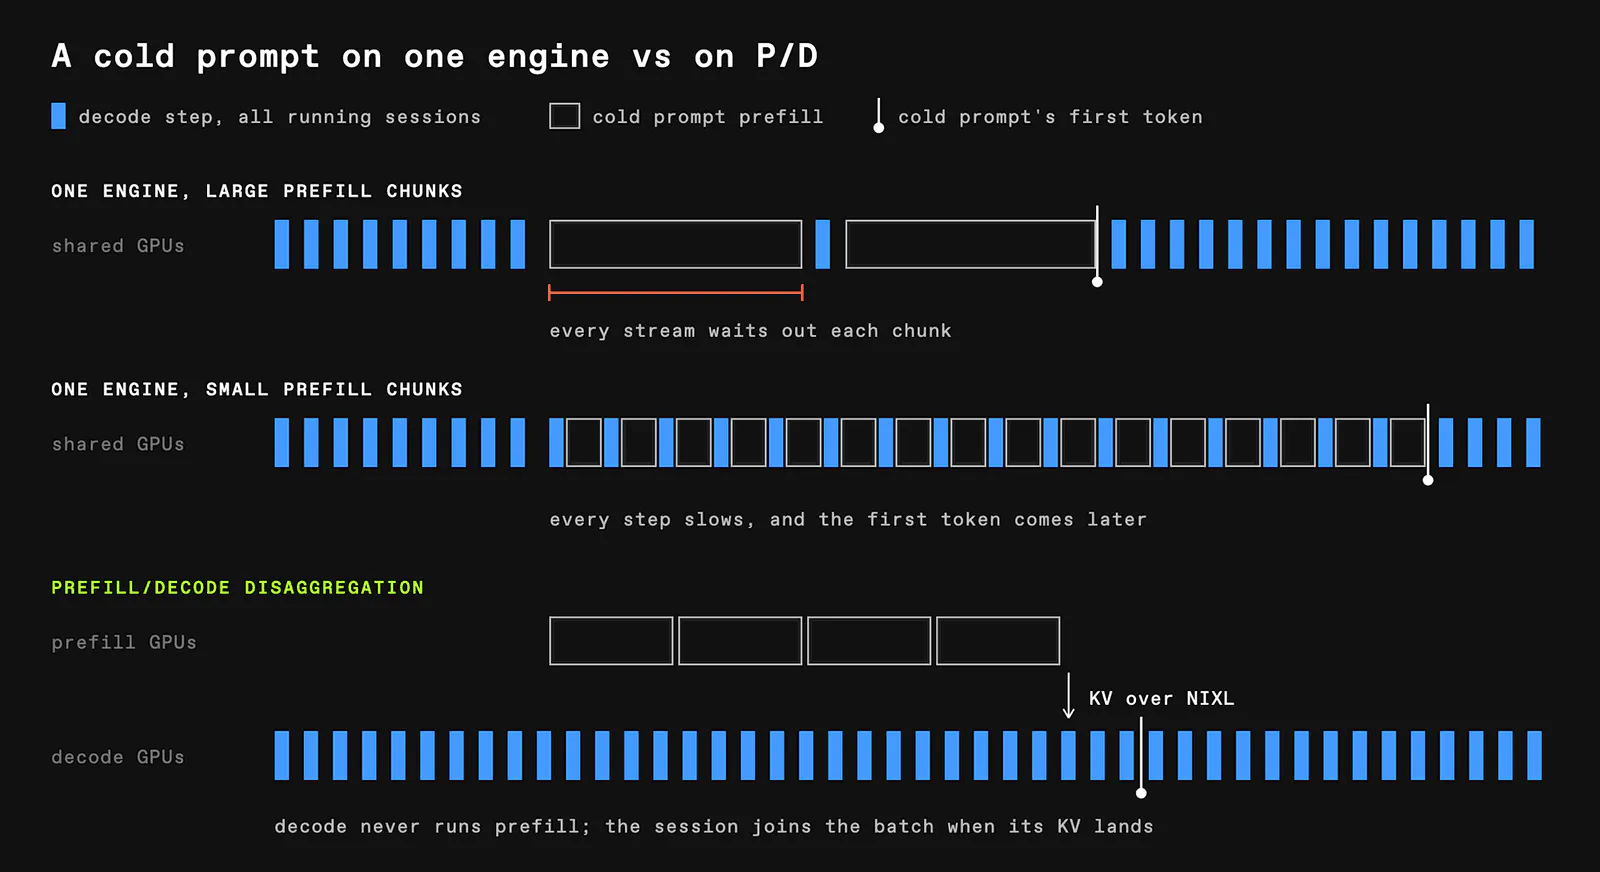
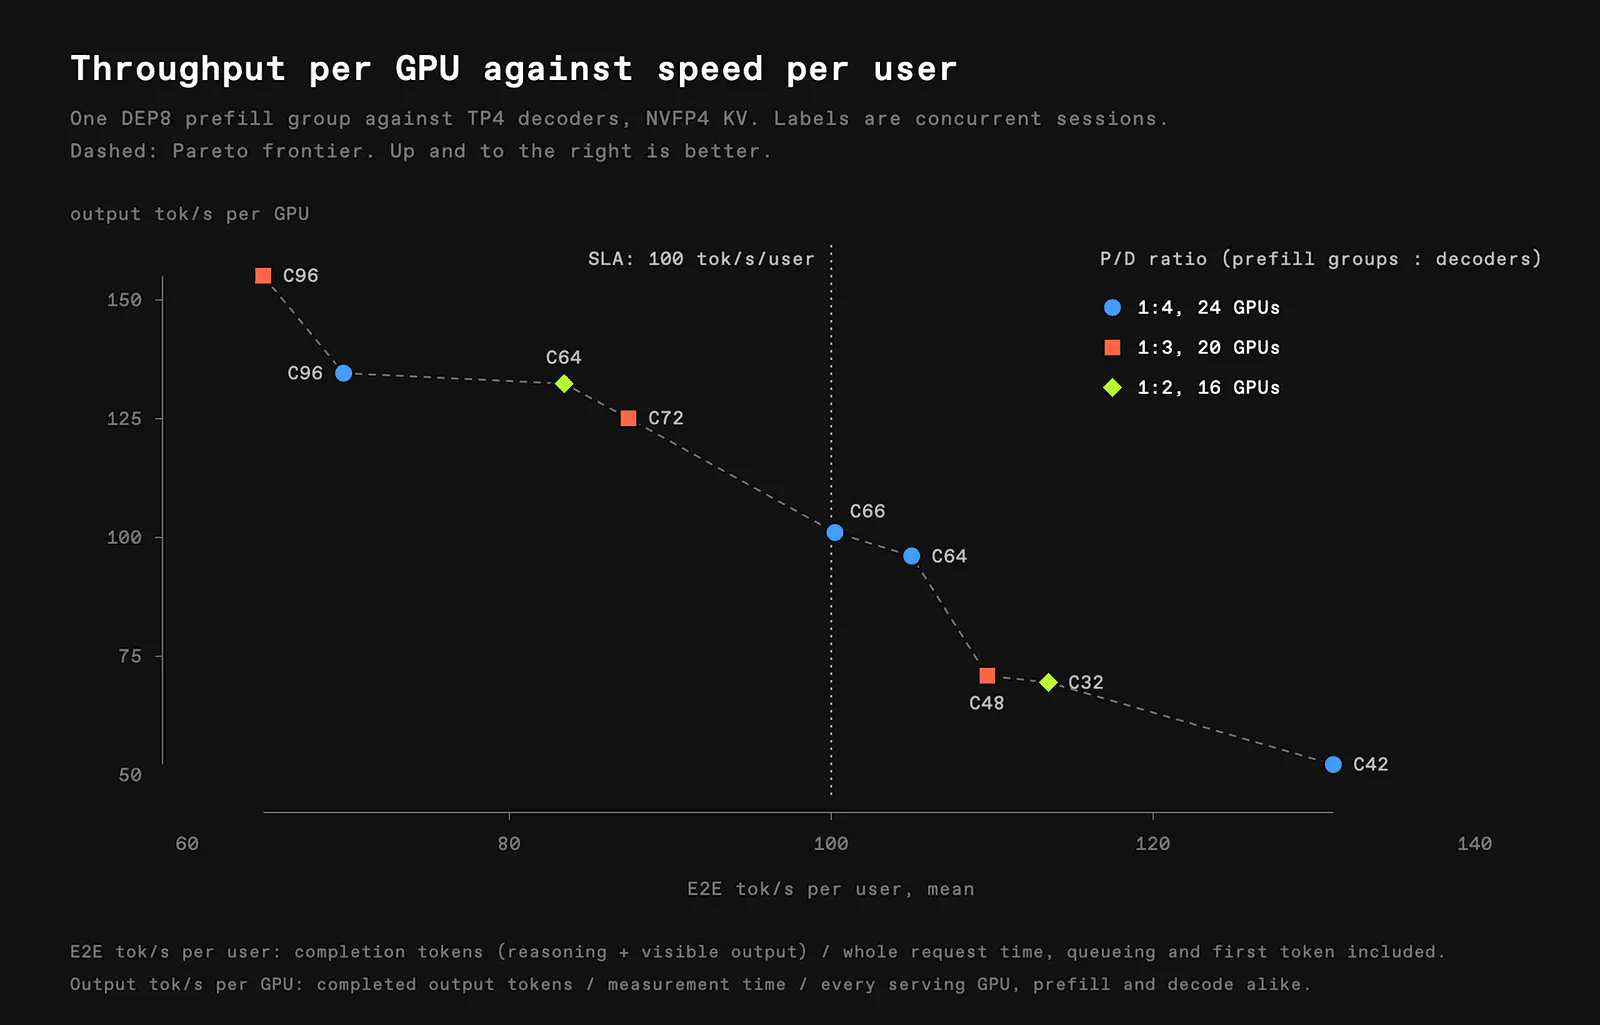
- プロンプト処理とトークン生成を別GPU群に分離し、Primeのテストでトークン間レイテンシーのp90を約40%削減。NVFP4圧縮によりキャッシュ容量も向上します。
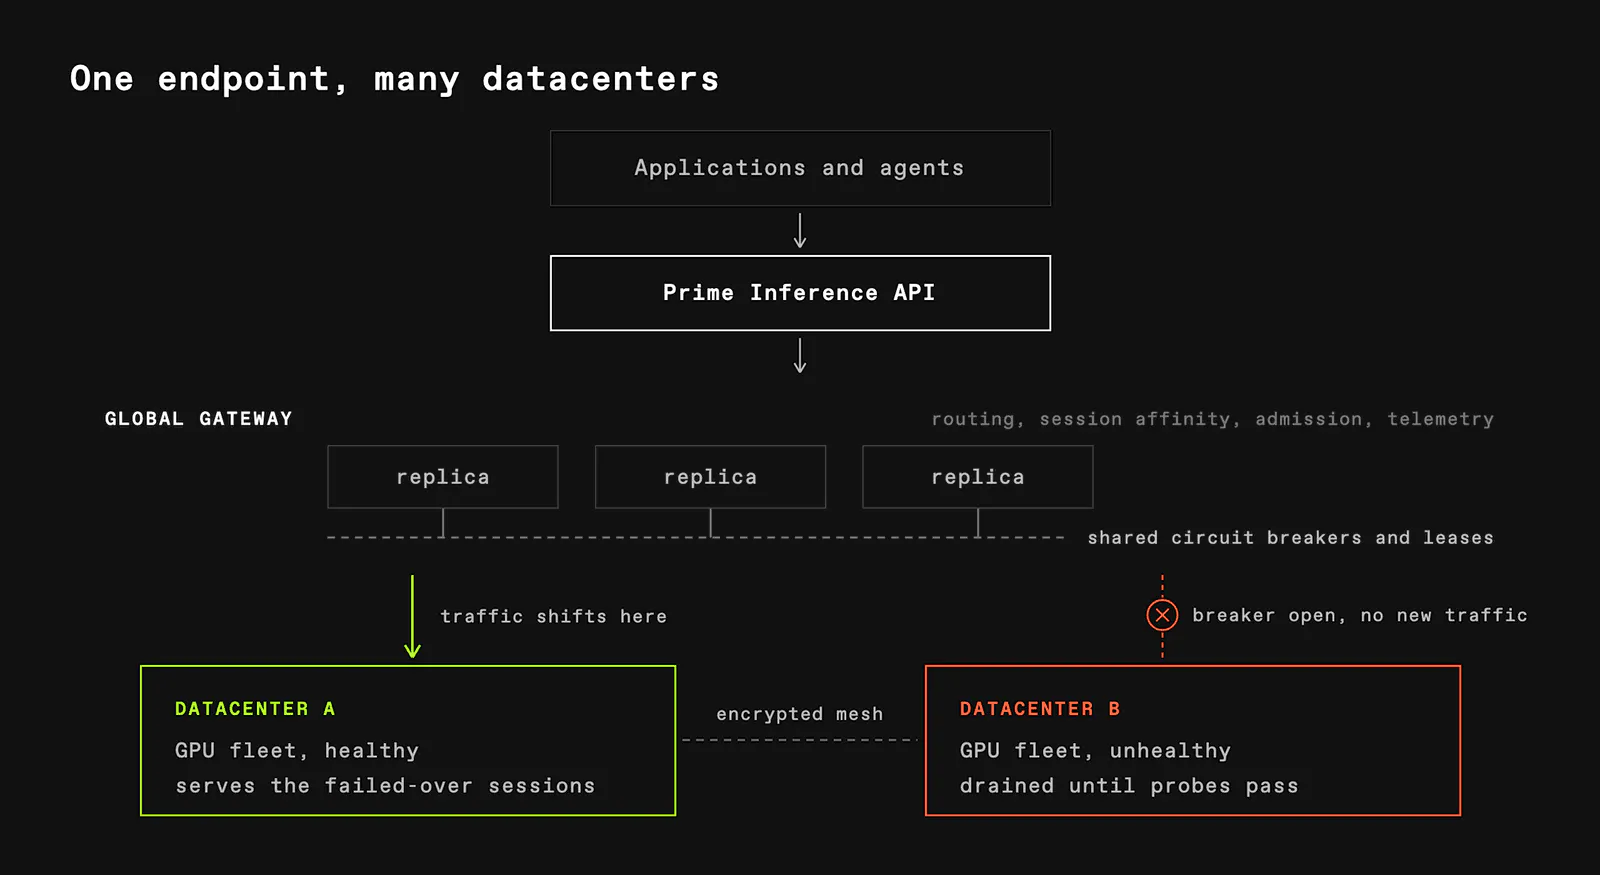
- OpenAI互換API、自動フェイルオーバー、24時間365日のハードウェア監視、統合請求、チーム単位の利用状況追跡に対応しています。
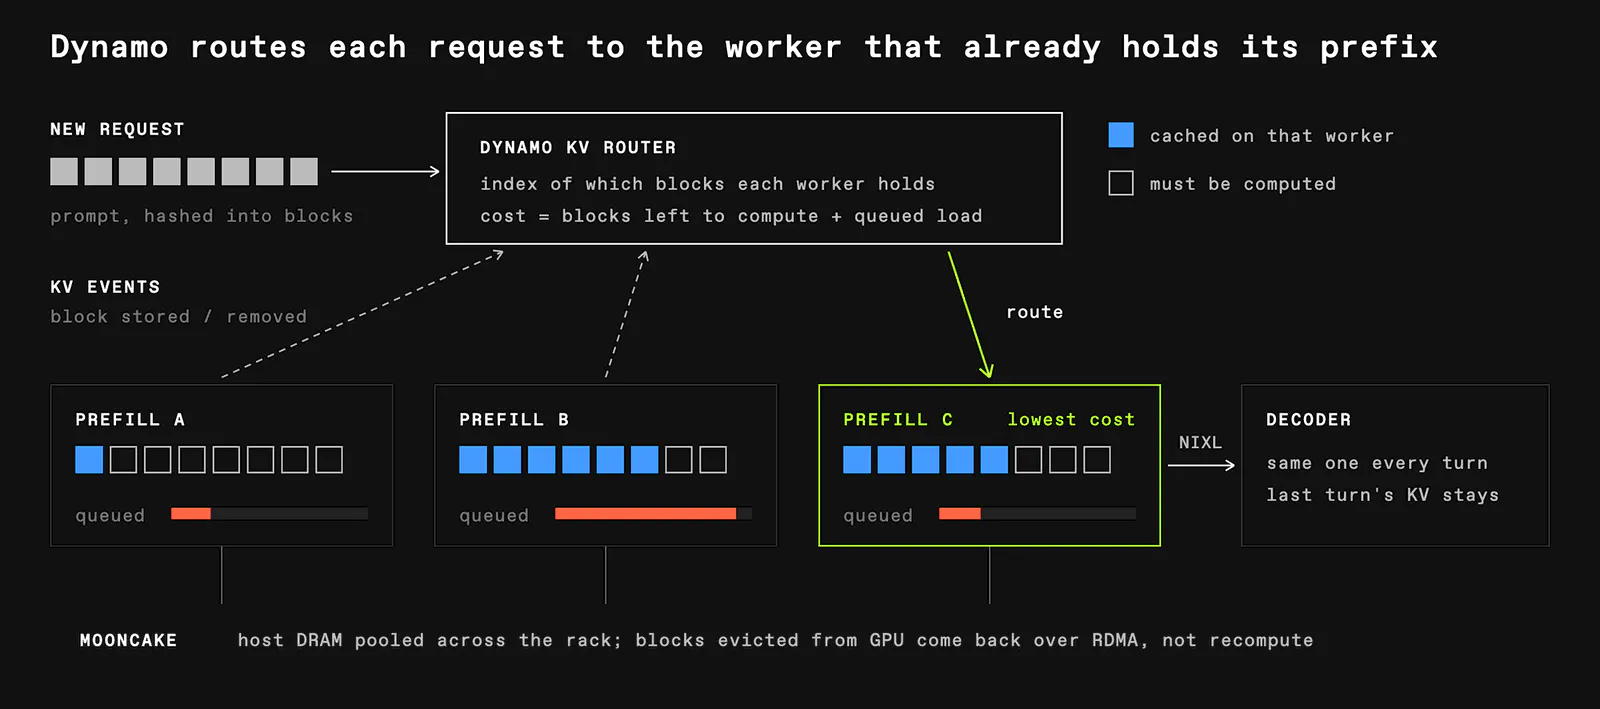
- NVIDIA Blackwell GPUを採用し、NVIDIA Dynamo、vLLM、Mooncake、FlashInferを基盤に、ツール呼び出しの不具合修正などを上流へ還元しています。
こんな人におすすめ
- オープンモデルでエージェント、コーディングアシスタント、評価、強化学習のワークロードを運用し、本番品質の速度と安定性を求めるチームに適しています。
- 自社でGPUフリートを構築・監視する負担を減らしながら、需要変動にはサーバーレス、継続的な負荷には予約容量で対応したい組織に向いています。
投票数: 3