Cekura Bench
ストックにはログインが必要です
実際の電話通話で音声間モデルを比較するベンチマーク
Artificial Intelligence
Developer Tools
SaaS
概要
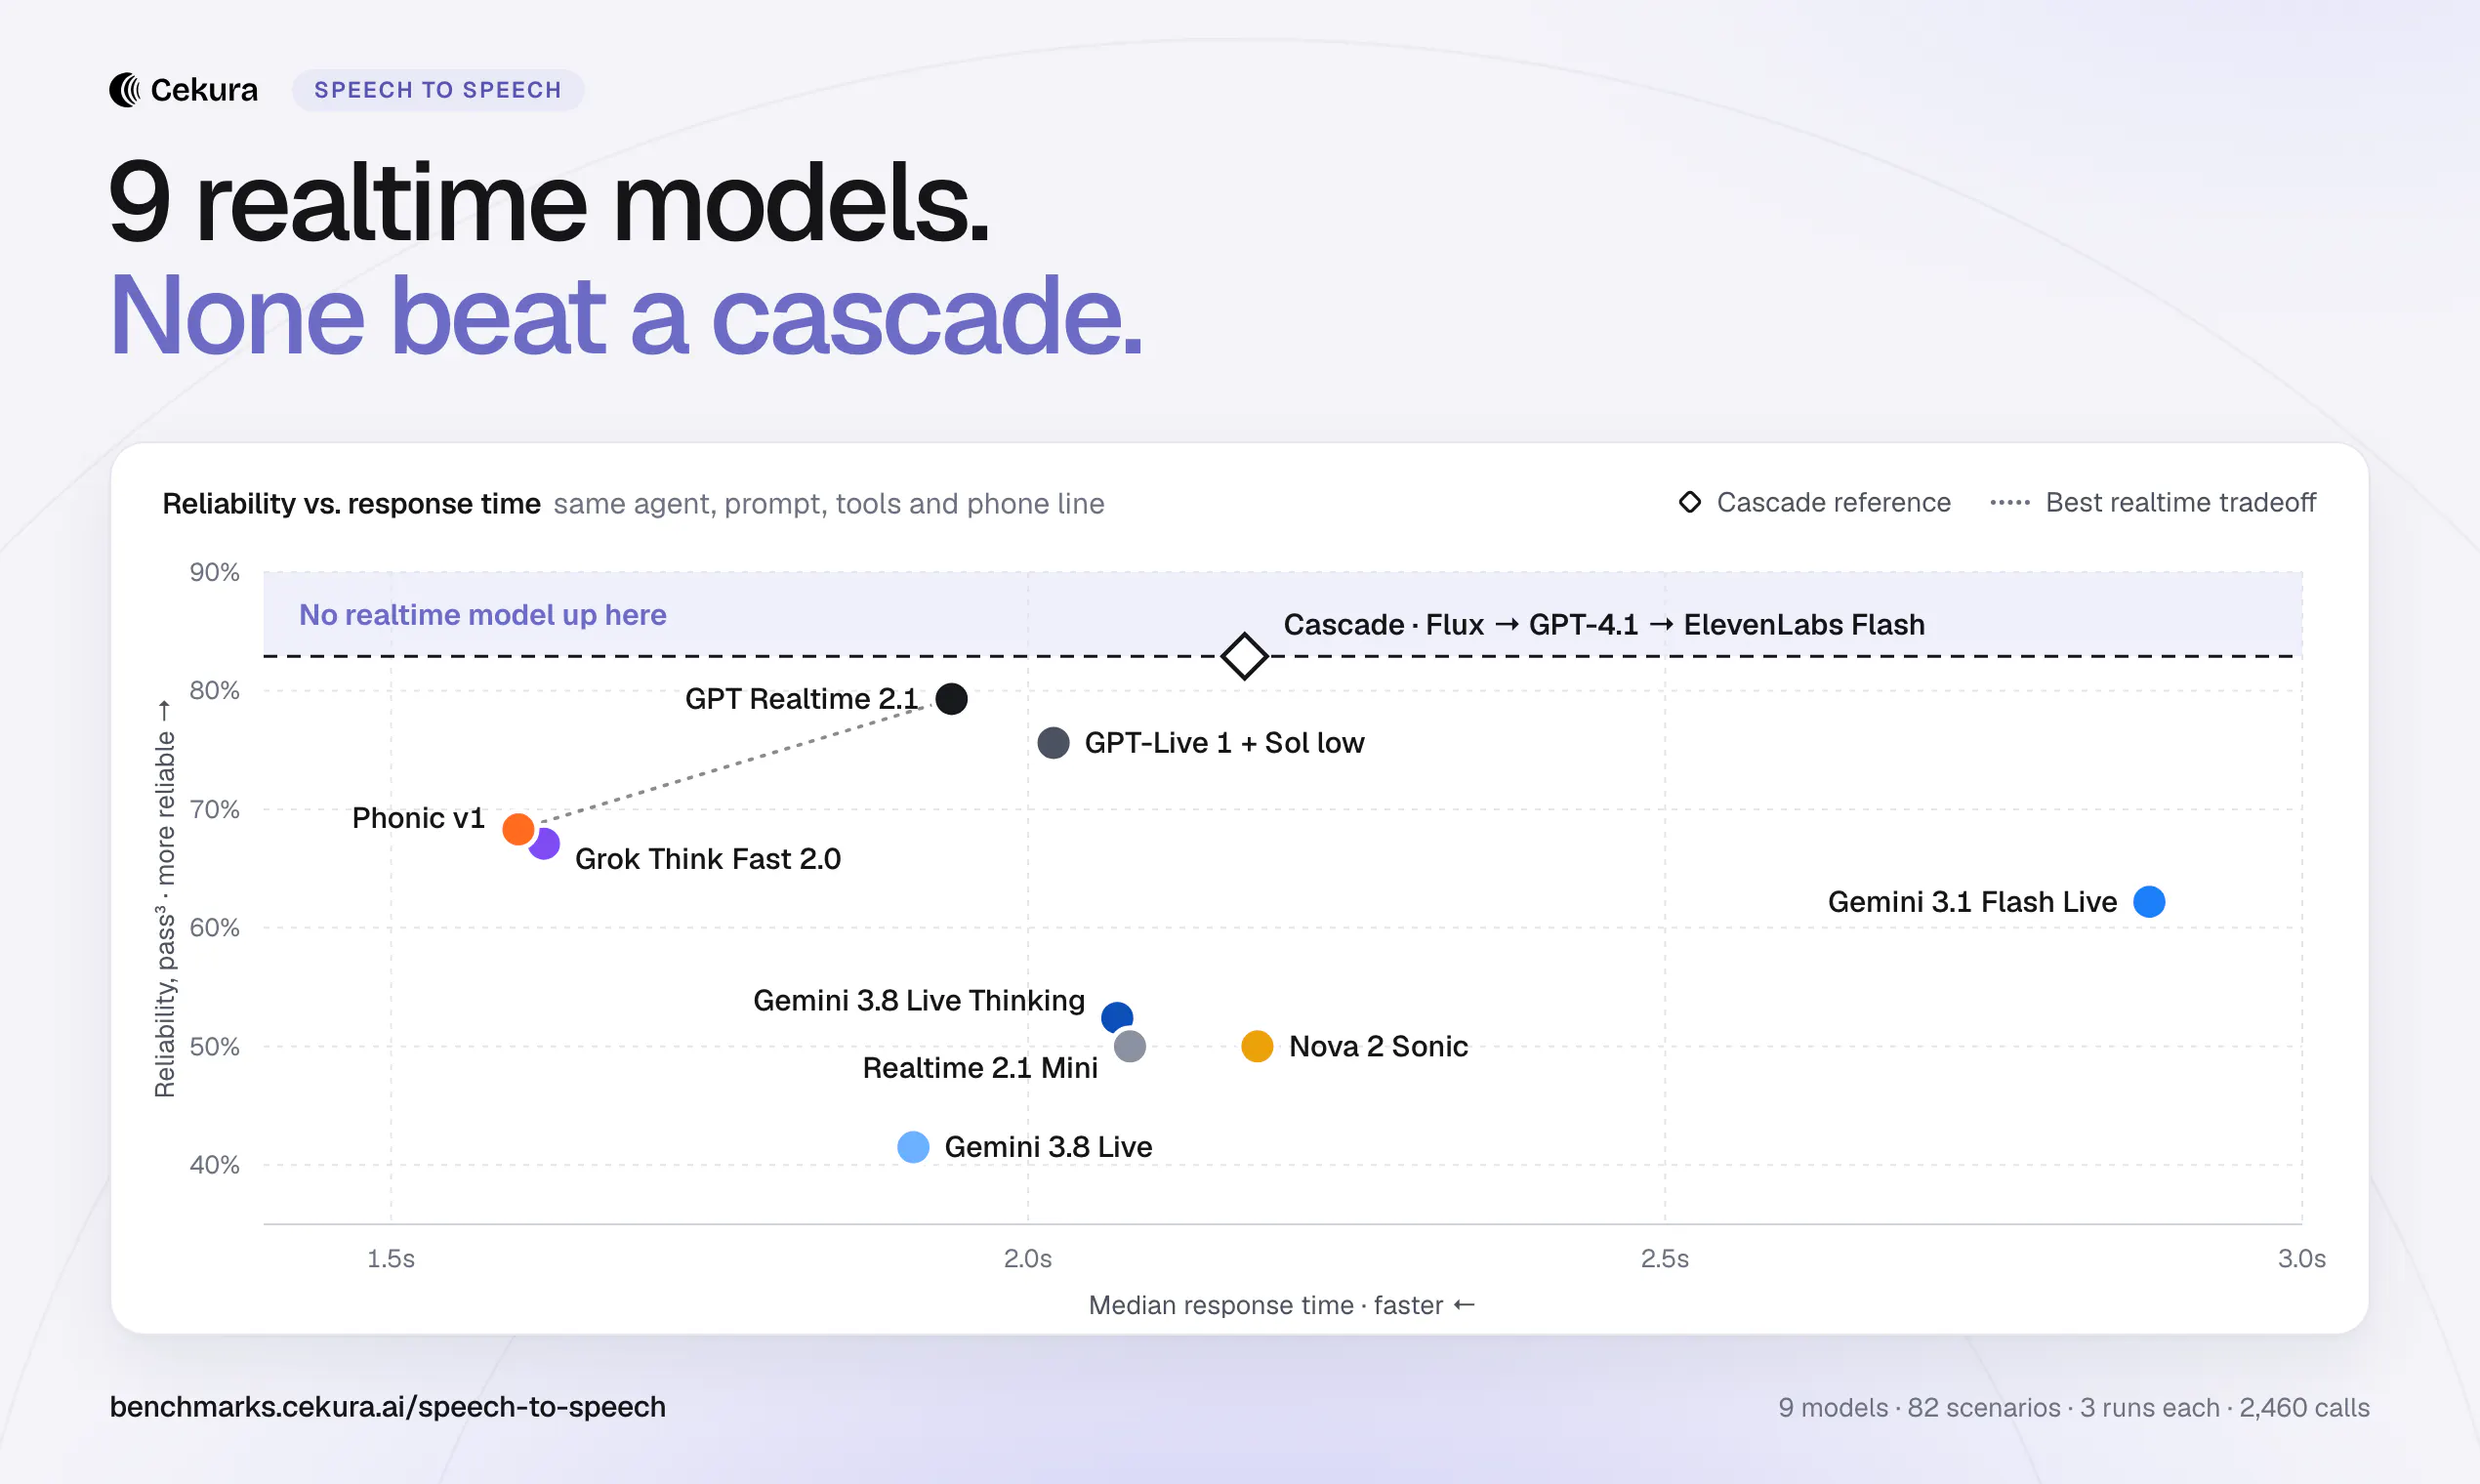
- 9種類のリアルタイム音声モデルを、同一の電話エージェント環境・プロンプト・ツール・電話回線で公平に比較できるベンチマークです。
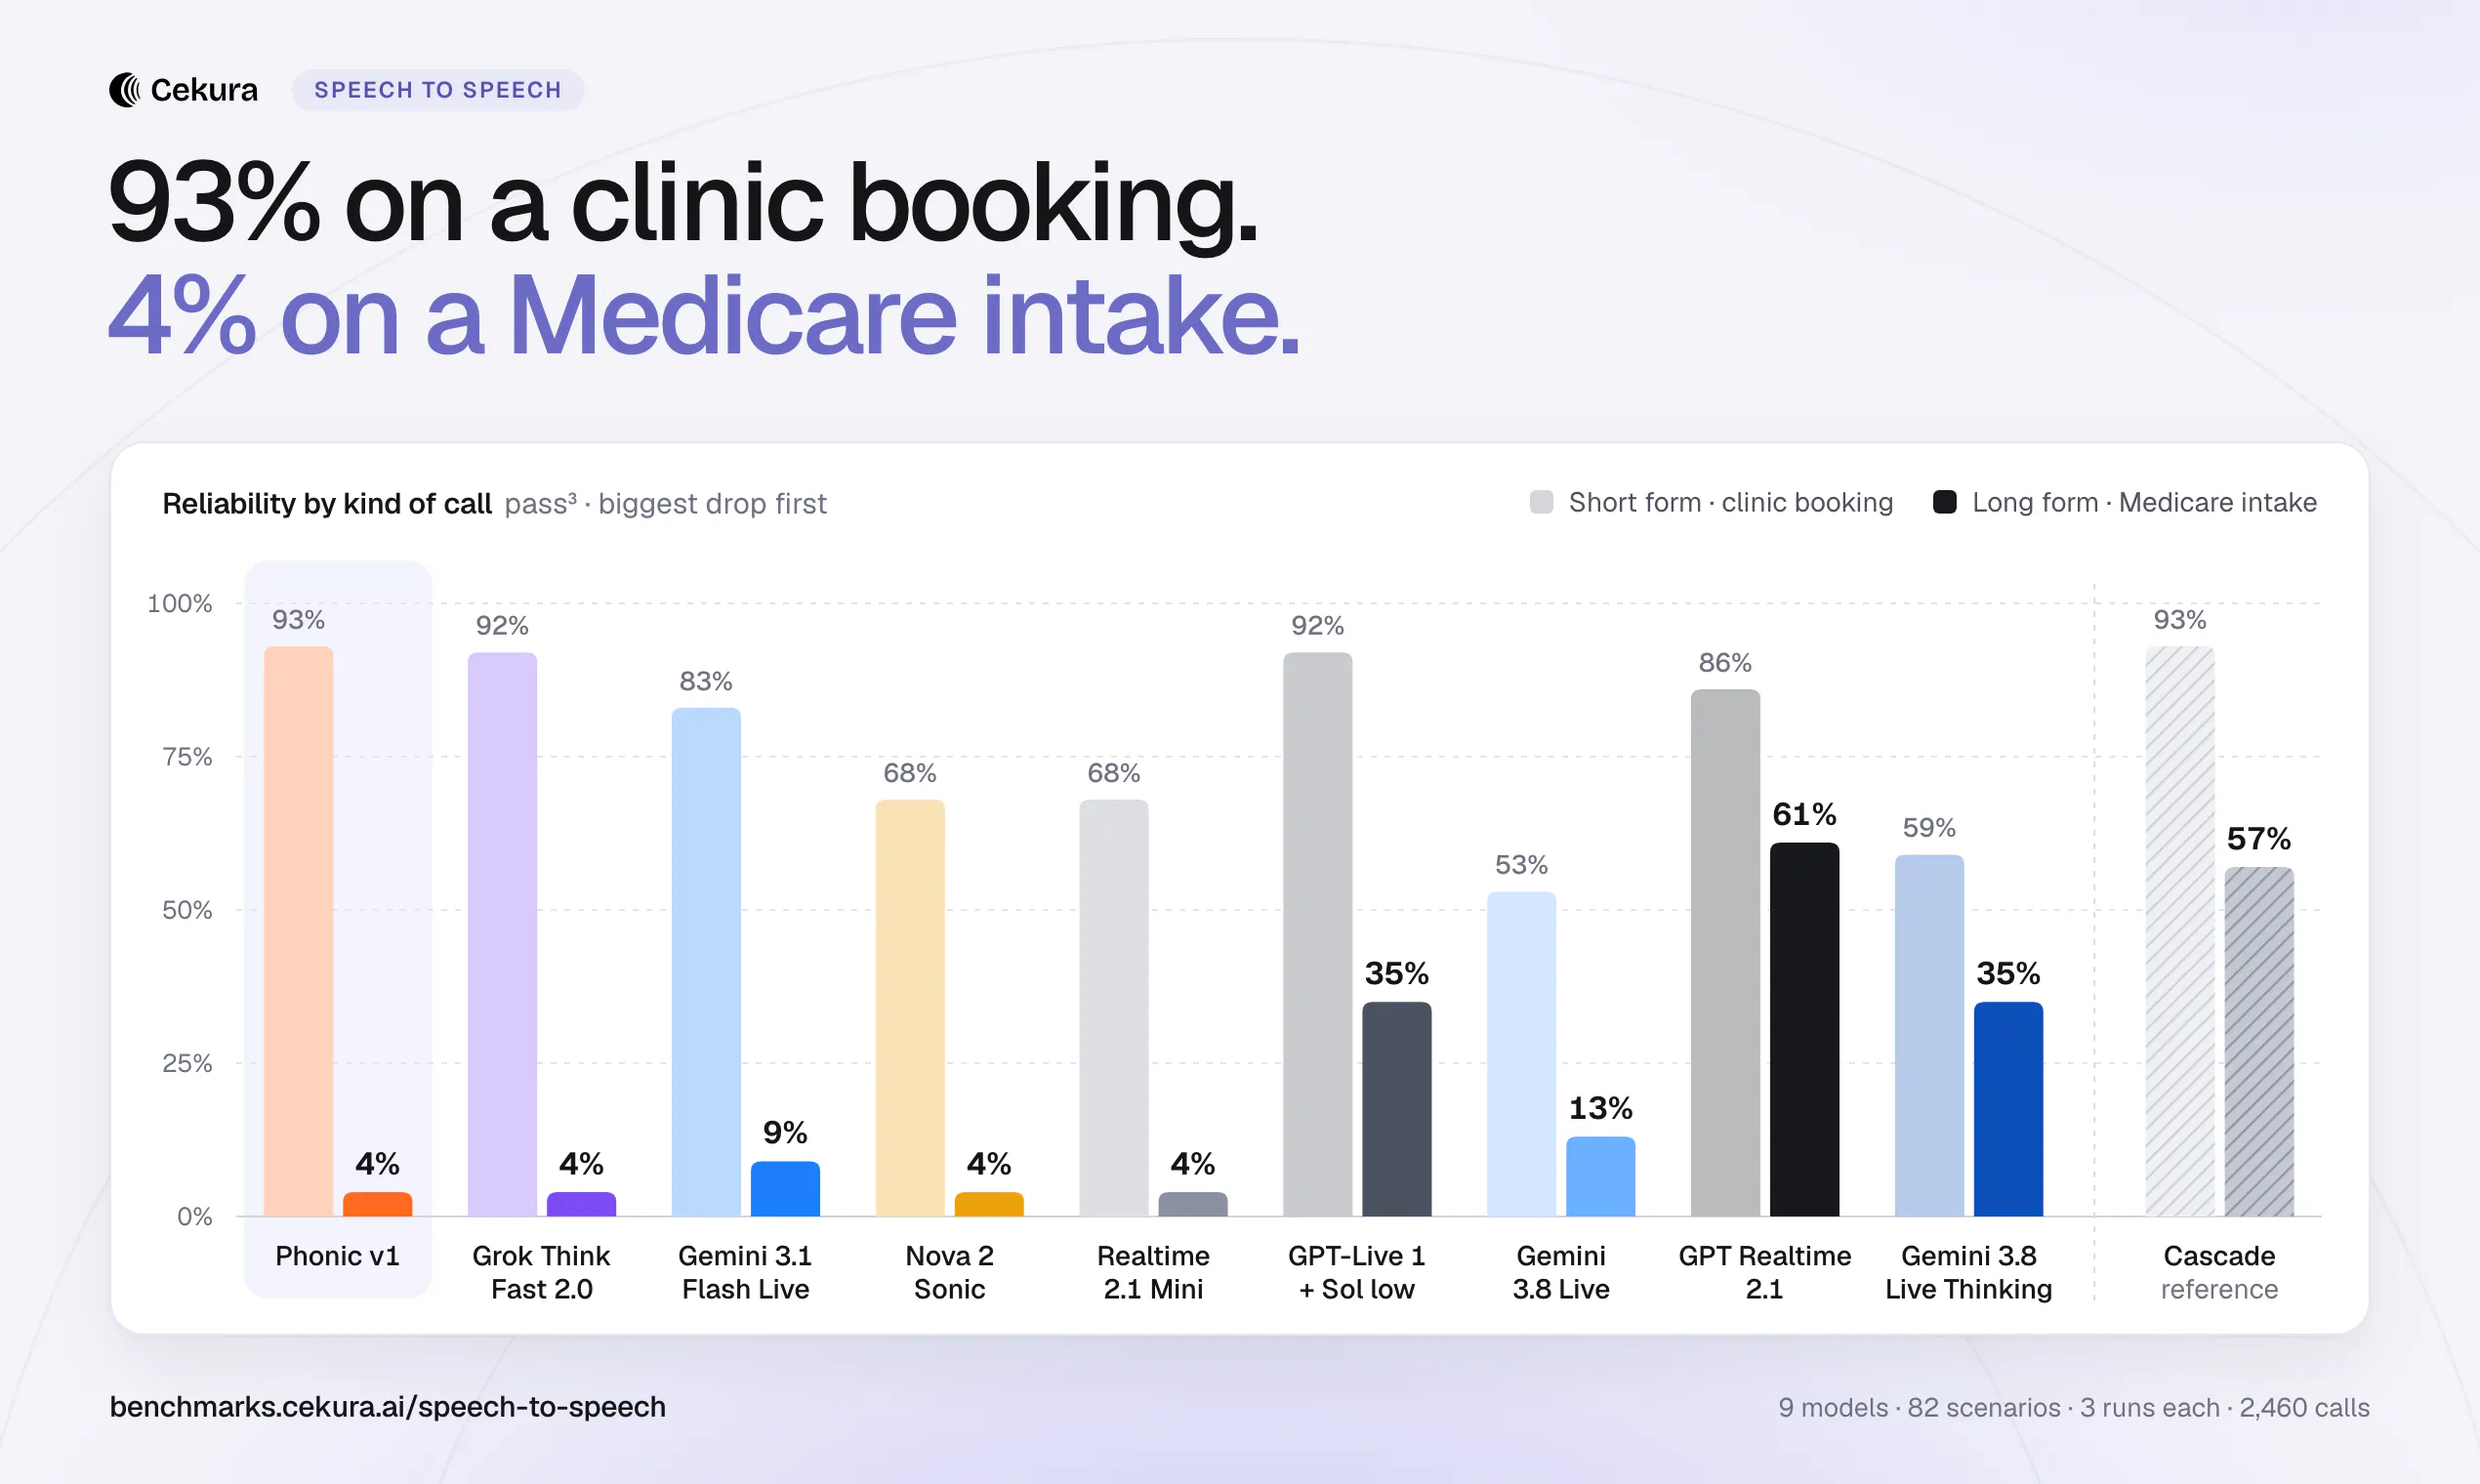
- 診療予約とメディケア受付の82シナリオを各3回実行し、正しい結果への到達と全項目の保存成功を合格条件としています。
- 各通話の文字起こし、ツール呼び出し、評価スコアを公開し、結果を追跡・検証できる透明性を備えています。
主な評価結果・特徴
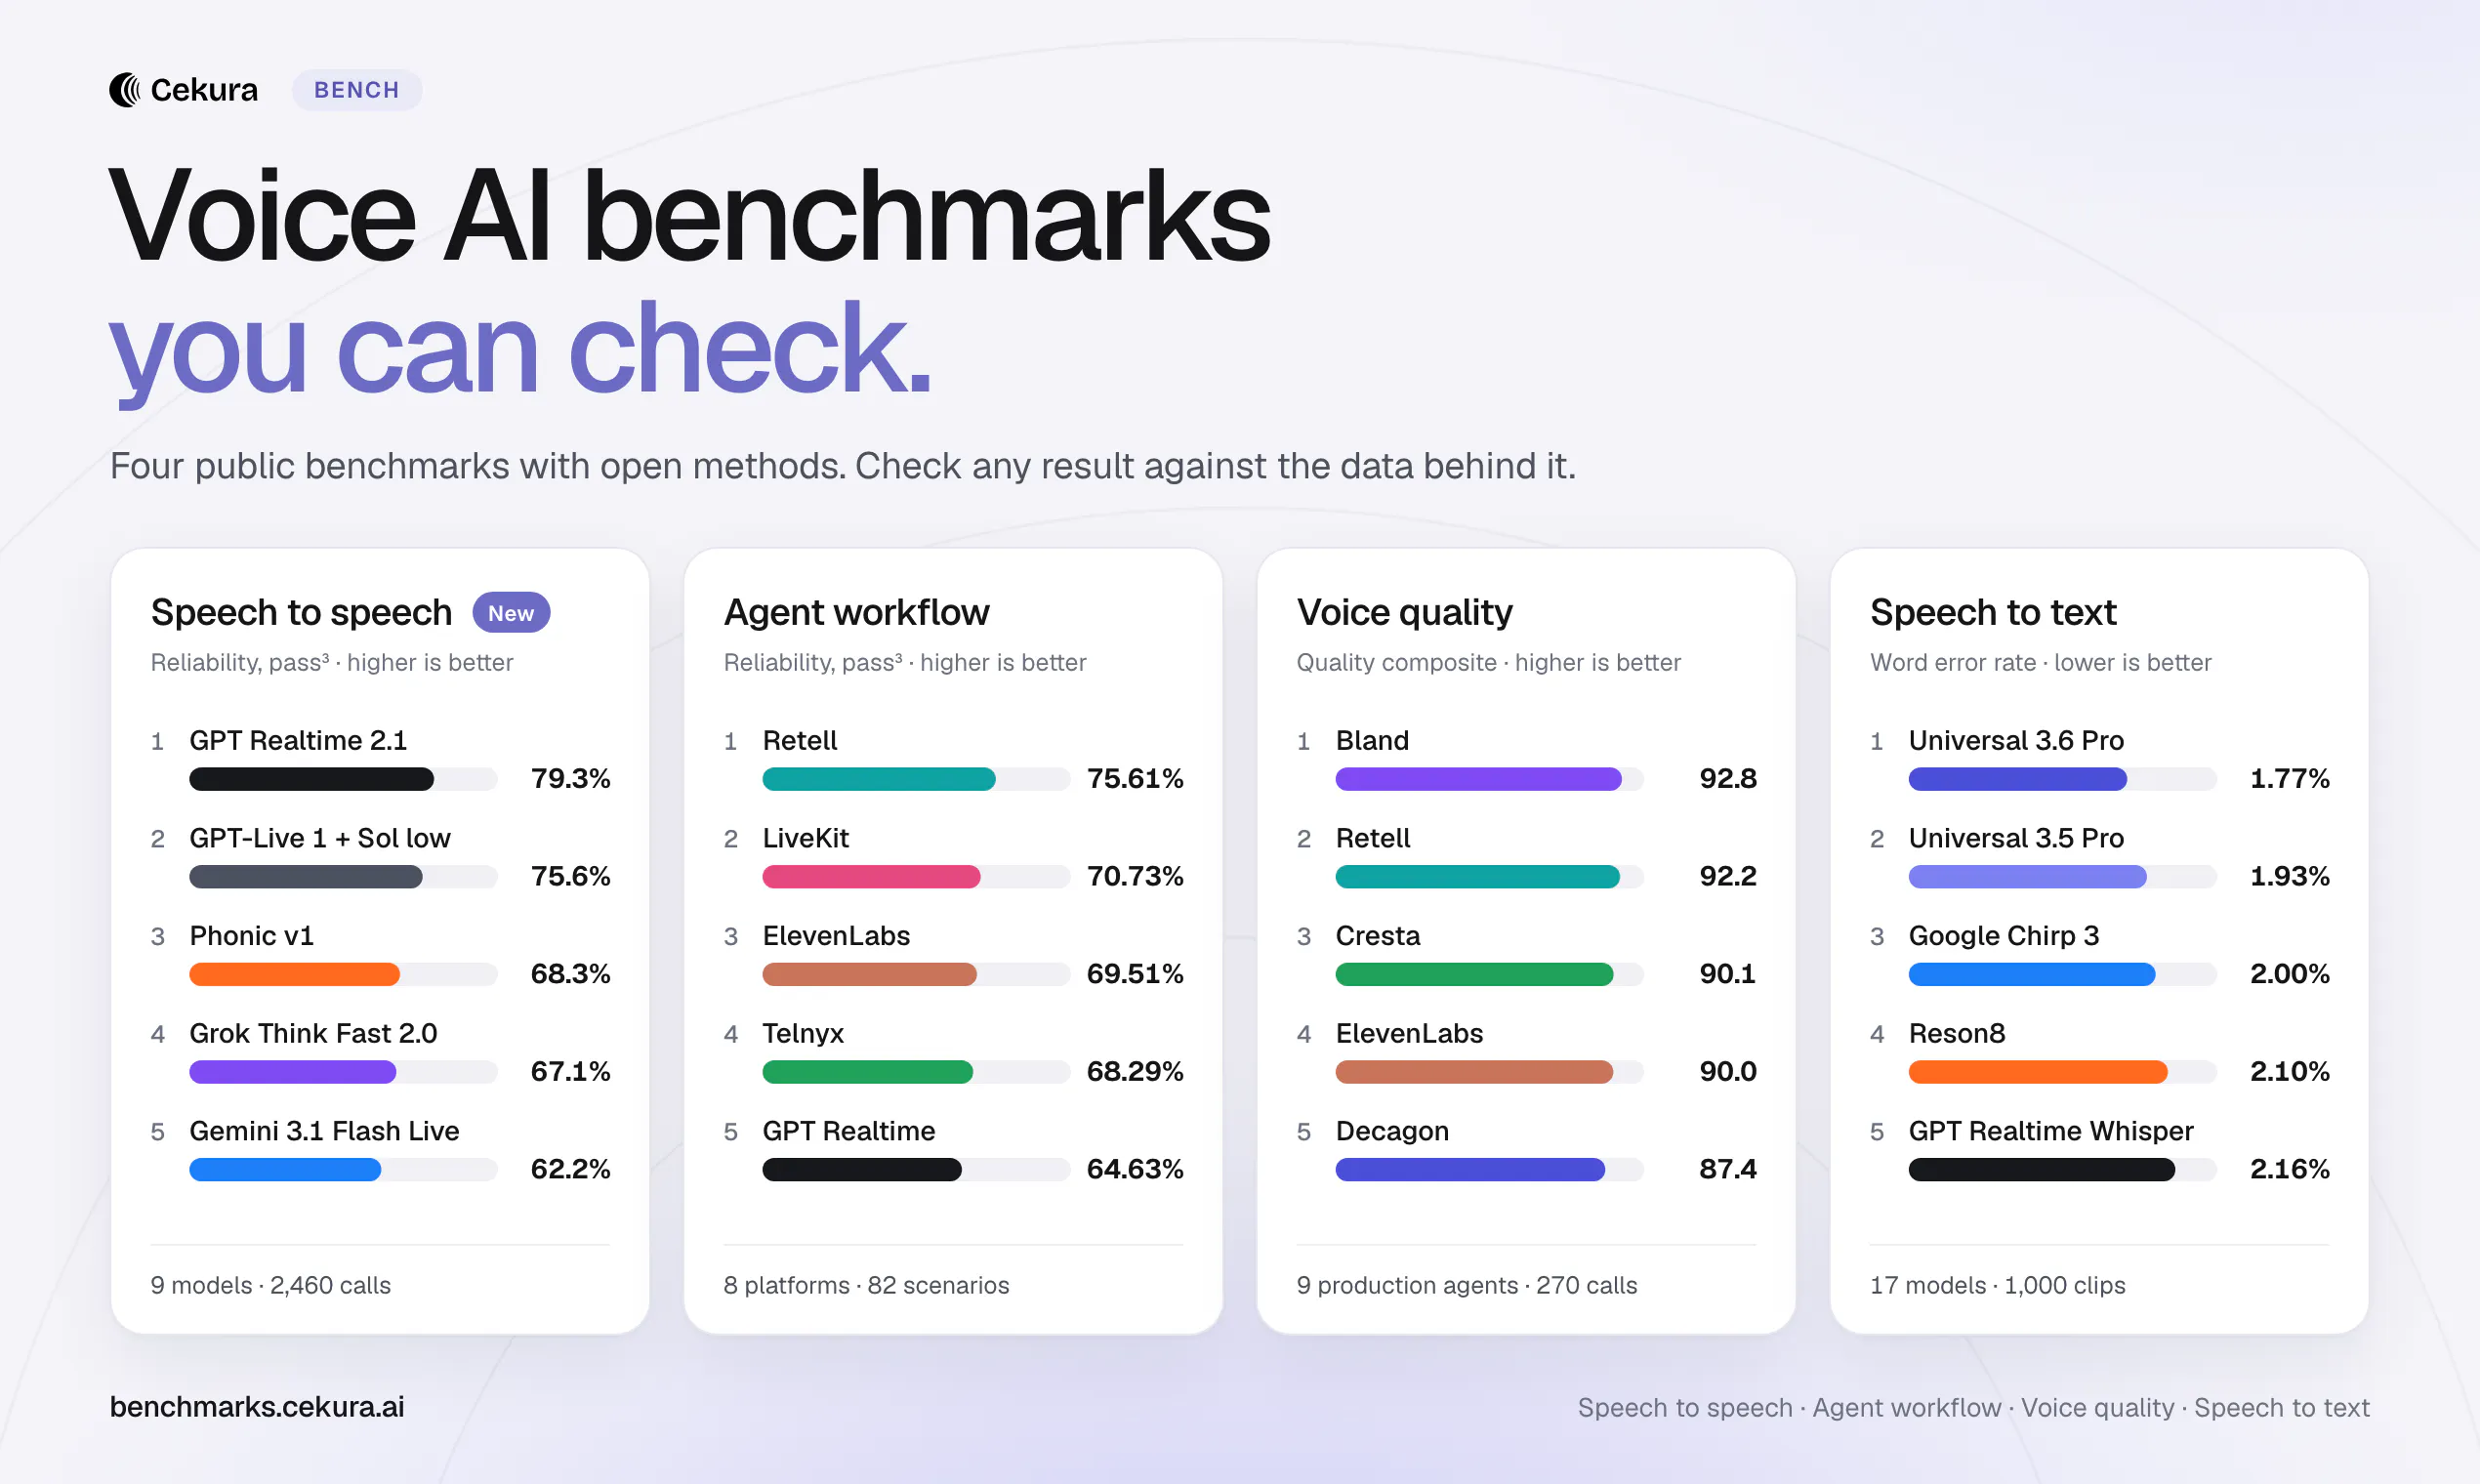
- GPT Realtime 2.1は3回すべてで成功したシナリオが79.3%となり、最も高い信頼性を記録しました。
- Phonic v1は中央値1.60秒の応答時間で最速、GPT Realtime 2.1 Miniは1分あたり0.020ドルで最も低コストでした。
- Flux、GPT-4.1、ElevenLabs Flashを組み合わせたカスケード構成は成功率82.9%で、全リアルタイムモデルを上回りました。
こんな人におすすめ
- 音声AIや電話エージェントを開発し、モデルごとの信頼性・速度・精度・コストを実際の通話で比較したいチームに適しています。
- ベンチマーク結果の根拠となる通話記録やテストケースを確認し、再現可能な評価を行いたい研究者やエンジニアに向いています。
- 導入モデルの選定や音声AIシステムの改善にあたり、STT・TTSを含む複数の評価データを参照したい方に役立ちます。
投票数: 143