Griffin by Tavus
ストックにはログインが必要です
世界初のHuman Interaction Model(人間インタラクションモデル)
Artificial Intelligence
概要
- Griffinは、見る・聞く・話すを同時に行い、対面での自然なリアルタイム会話を再現するTavusのAIモデルです。
- 1分間のビデオ通話で48%の参加者が人間と会話していると感じたとされ、NVIDIAの独立評価でも対面型AI部門で1位に選ばれています。
主な特徴
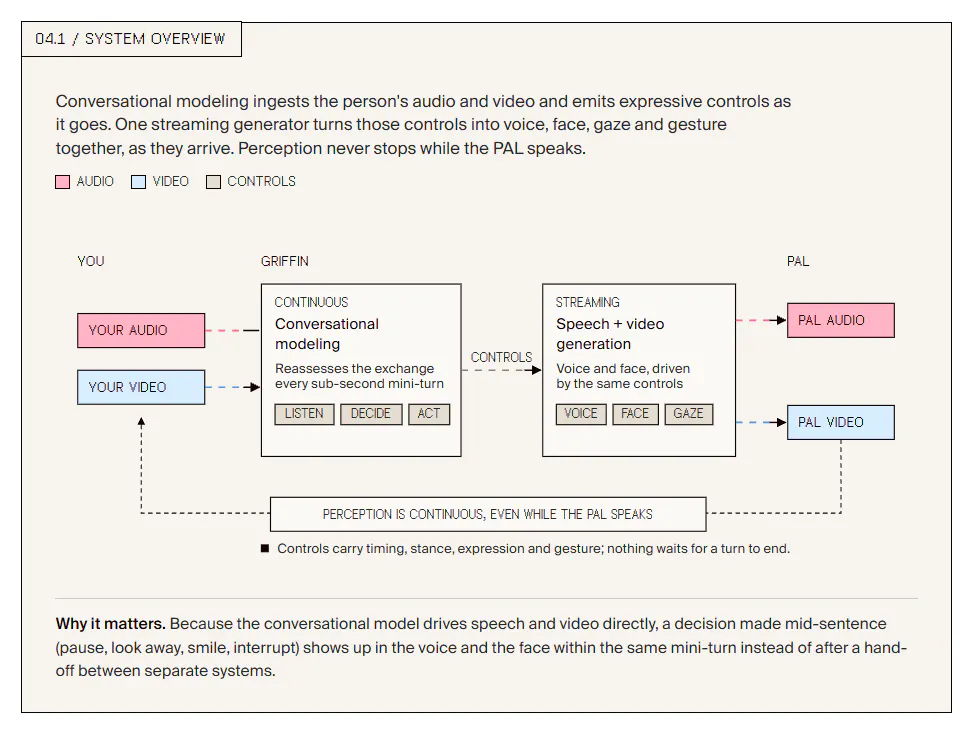
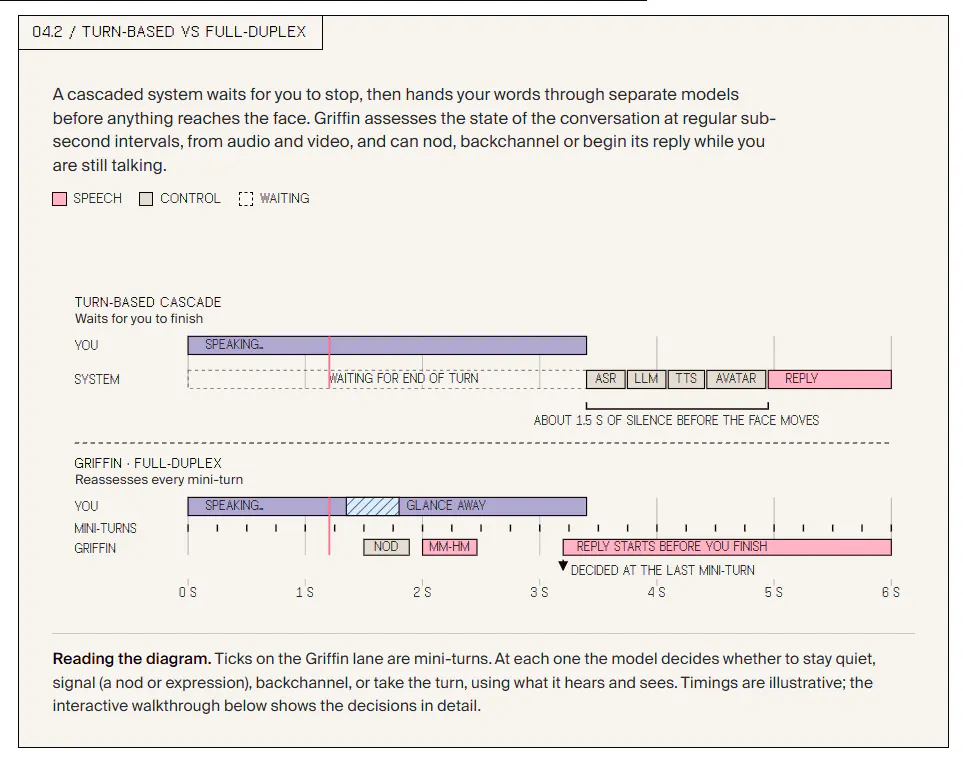
- 全二重の映像対話により、相手の発話を待つだけでなく、割り込みや相づち、沈黙への反応を自然なタイミングで行えます。
- 映像と音声を継続的に解析し、表情、ジェスチャー、声のトーン、カメラに映る視覚情報を会話に反映します。
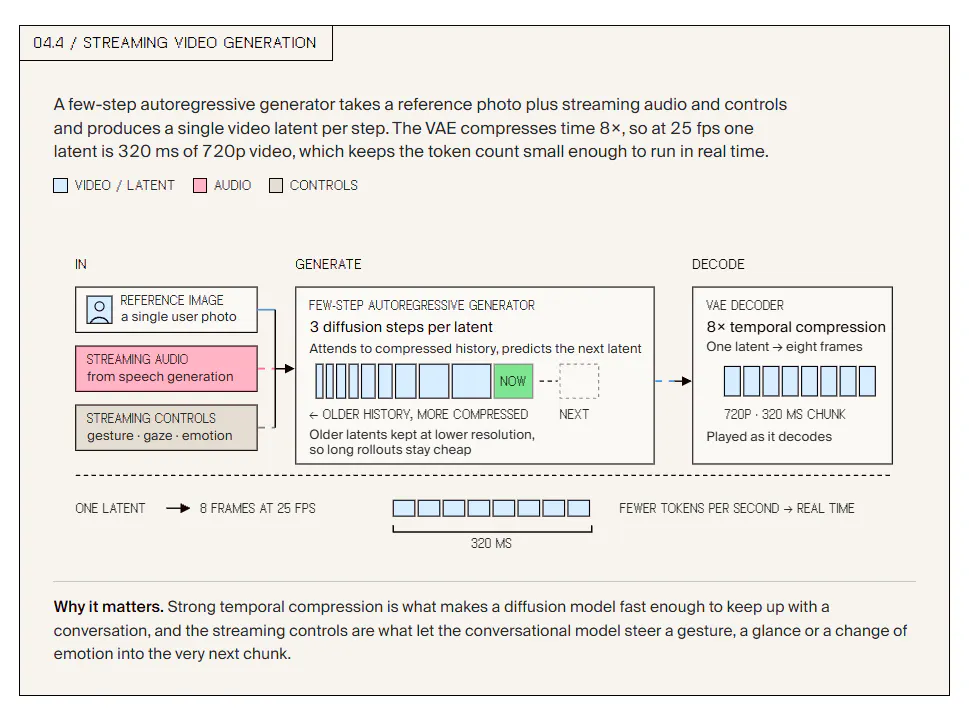
- 320ミリ秒単位で720p映像を生成し、約10秒の音声サンプルから話者の声を再現できる機能も備えています。
提供状況と対象ユーザー
- 現在はGriffin-Liteが一部の初期テスター向け研究プレビューとして提供されており、一般の顧客利用には対応していません。
- 自然な対面型AI、リアルタイム映像生成、人間らしい会話インタラクションを研究・検証したい開発者や研究者に適しています。
- Tavusは安全性に関する課題への対応後、より広い提供を予定しており、現時点では選ばれたテスターが主な対象です。
投票数: 0